系列导航
本系列从 Pod 网络连通入手,逐步展开到 K8s 网络全景。
① 概念 → ② Flannel → ③ Calico → ④ 流量路径 → ⑤ Cilium → ⑥ 对比 → ⑦ 排障 ‖ ⑧ 开发 → ⑨ 多网卡 → ⑩ AI 演进
| 顺序 | 文章 | 定位 |
|---|---|---|
| ① | 概念与入门 | 基础——主机网络、Docker 网络、CNI 标准、方案分类树 |
| ② | Flannel 详解 | CNI 实现——Overlay(UDP/VXLAN)+ Underlay(HostGW)与抓包 |
| ③ | Calico 详解 | CNI 实现——Overlay(VXLAN/IPIP)+ Underlay(BGP)+ NetworkPolicy |
| ④ | 本篇 - 流量路径全解析 | 全貌——Pod/Service/Ingress/Egress,揭示 CNI 的边界 |
| ⑤ | Cilium 详解(超CNI) | 超 CNI——eBPF 数据平面(Service + NetworkPolicy)+ CNI 连通(VXLAN/BGP) |
| ⑥ | 插件对比与选型 | 选型——5 插件横向对比 + 决策树 |
| ⑦ | 排障思路与常用命令 | 运维——工具链 + 场景排查 + 性能 |
| — | 核心路径 ↑ | 扩展展望 ↓ |
| ⑧ | CNI 插件开发指南 | 扩展——基于 CNI 规范开发自定义插件 |
| ⑨ | 多网卡方案详解 | 进阶——Multus + SR-IOV/ipvlan 多网口实战 |
| ⑩ | AI 时代网络演进 | 展望——GPU 网络、eBPF 加速、未来方向 |
前面几篇讲「网络怎么搭」,本篇换一个视角——从不同通信维度分析流量实际怎么走。以下以 Flannel(网桥模型)+ kube-proxy 为基础,讲清各对象间流量的原理与概念;Calico 的实现差异见文末 §7,Cilium 见下一篇。
0. 前置知识:四表五链与数据包流向
理解流量路径前,先明确数据包在内核网络栈的流向。Netfilter 在 5 个位置挂载 iptables 链,包经过哪些链由「流向」决定,不经过的链不会起作用。
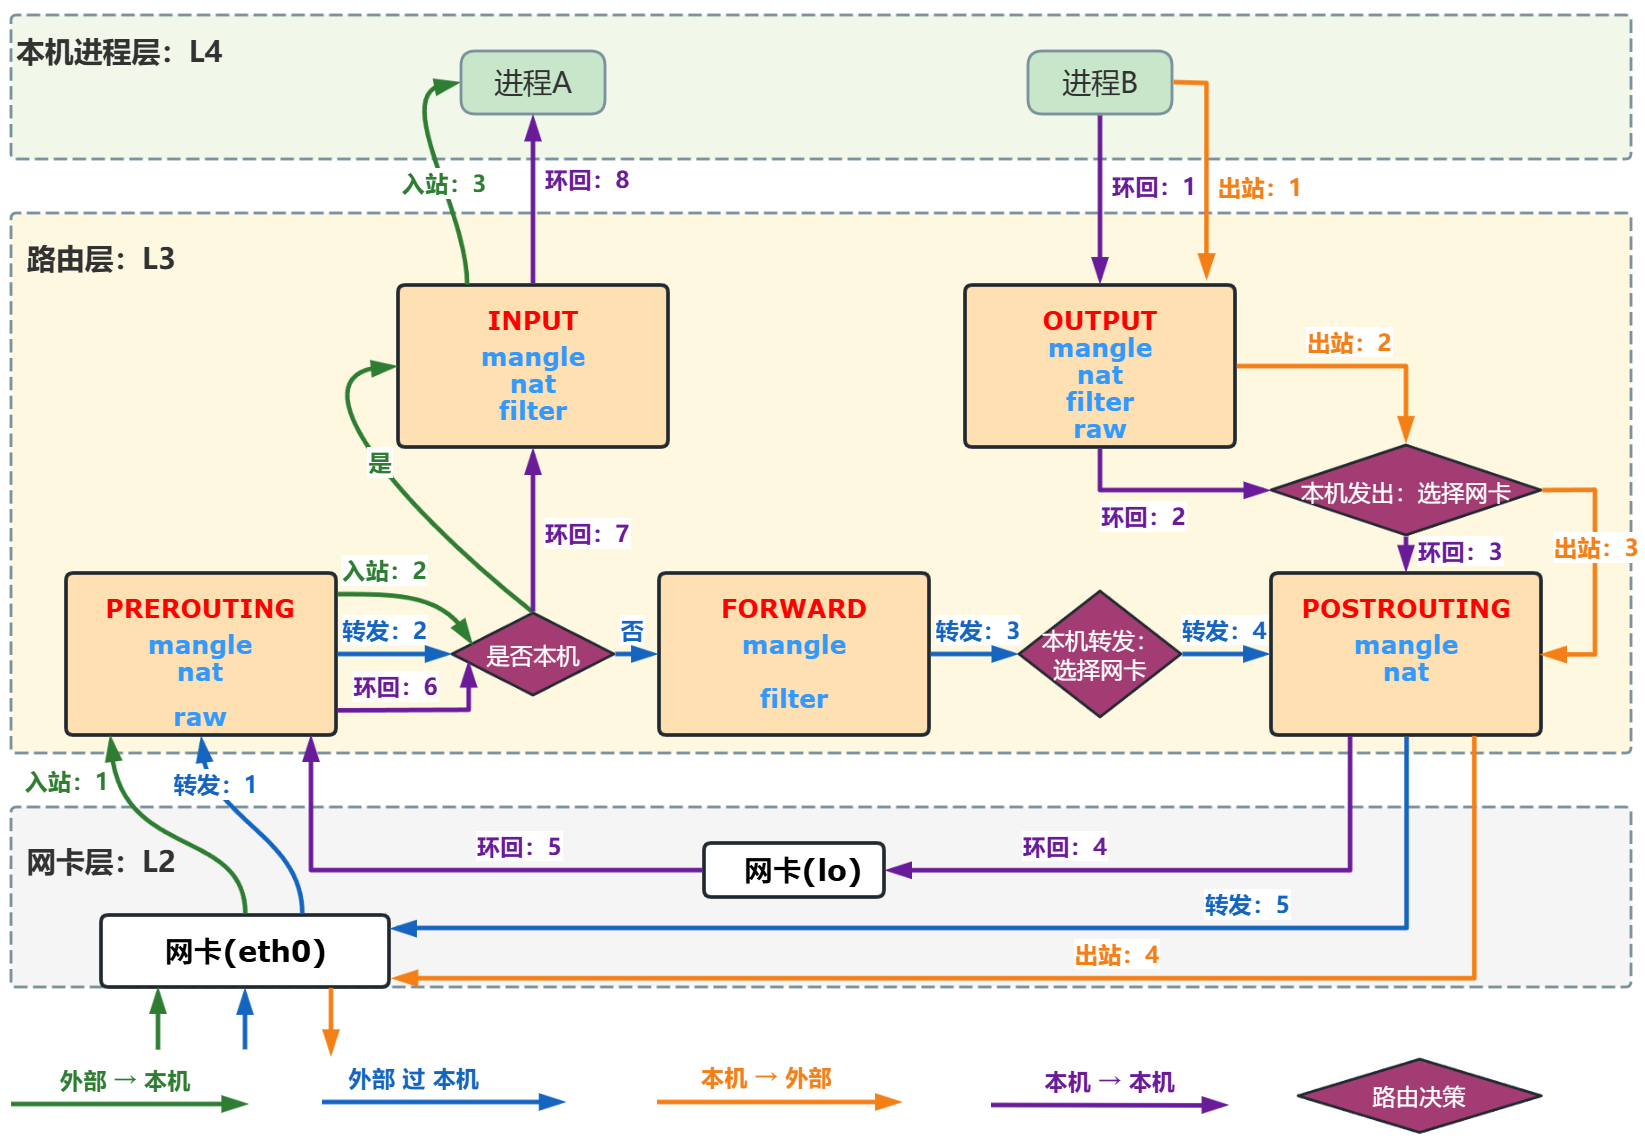
| 链 | 作用位置 | 处理的流量 |
|---|---|---|
| PREROUTING | 入站第一站(路由决策前) | 所有入站包(DNAT 通常在此) |
| INPUT | 路由决策后,目标是本机 | 到达本机的包 |
| FORWARD | 路由决策后,目标不是本机 | 被转发的包 |
| OUTPUT | 本机进程产生的包 | 出站包(DNAT 也在此) |
| POSTROUTING | 出站最后一站 | 所有出站包(SNAT/MASQUERADE 通常在此) |
0.1 四表 × 五链
iptables 按「功能」分表、按「位置」分链,规则就是表内规则挂在链上。四张表各管一类事,挂载的链由各自功能决定:
| 表 | 挂载的链 | 记忆诀窍(内核对数据处理的时间顺序) |
|---|---|---|
| raw | PREROUTING + OUTPUT | 「最早干预」:在 conntrack 之前提前「赦免」某些包,让它们不被记录。只出现在包进入系统(PREROUTING)和本机产生(OUTPUT)的最源头 |
| mangle | 全部 5 条链 | 「全能修改器」:修改包头(TOS、TTL、打标记),无论包走到哪个生命阶段,只要想改就能改,所以 5 条全挂 |
| nat | PREROUTING / INPUT / OUTPUT / POSTROUTING(唯独缺 FORWARD) | 「地址转换」:DNAT(改目标)在路由前(PREROUTING)和本机发出前(OUTPUT);SNAT(改源)在离开前(POSTROUTING)。不在 FORWARD 是因为 FORWARD 只做转发不做地址转换,内核不允许在转发路径上修改目标地址(避免路由混乱) |
| filter | INPUT / FORWARD / OUTPUT(唯独缺 PREROUTING / POSTROUTING) | 「过滤拦截」:收归我的(INPUT)、我转发的(FORWARD)、我发出的(OUTPUT)才需要拦截。PREROUTING 还没决定发给谁,POSTROUTING 已经准备走,这两处不适合做丢弃(DROP)或放行(ACCEPT) |
同一链上四表按固定优先级执行:raw → mangle → nat → filter(不是按挂载顺序)。
对本系列的影响:kube-proxy 的 KUBE-* 链就挂在 nat 表(DNAT 在 PREROUTING/OUTPUT,MASQ 在 POSTROUTING),NetworkPolicy 则落在 filter 表(INPUT/FORWARD/OUTPUT)。
四条主要流向:
① 外部来本机(入站):  eth0 → PREROUTING → INPUT → 进程A
② 外部过本机(转发):  eth0 → PREROUTING → FORWARD → POSTROUTING → cni0/eth0
③ 本机去外部(出站):  进程B → OUTPUT → POSTROUTING → eth0 → 外部
④ 本机进程互访(环回):进程A → OUTPUT → POSTROUTING → lo → PREROUTING → INPUT → 进程B
要点:
- ④ 本机进程互访(如
curl 127.0.0.1:8080、访问本机物理网卡 IP):包从 OUTPUT 发出,内核发现目标就是本机自己,交给 lo 环回接口;lo 把包当作「新收到的包」重新进入入站路径(PREROUTING → INPUT)。整个过程相当于出门绕一圈又从后门进来。 - lo 只出现在本机进程互访:跨 Pod、跨节点的流量都不经过 lo。
- Unix Domain Socket(如 /var/run/docker.sock)不经过这套流程:不走 TCP/IP 协议栈,不触发任何 iptables 链。
对本系列的影响(K8s Service):
- 绝大多数 Service 流量是「①/②」形态:从 Pod 或外部进入,kube-proxy 在 PREROUTING 做 DNAT。
- 宿主机进程访问 Service(如 kubelet 调 API)是「③」形态:从 OUTPUT 进入,kube-proxy 在 OUTPUT 做 DNAT。
- 注意:宿主机进程访问 ClusterIP 时,OUTPUT 做 DNAT 后目标是 Pod IP(不是本机地址),包走 cni0/eth0 直接到后端,不绕 lo。只有后端是「同节点 hostNetwork Pod」时,DNAT 后目标 = 本机 IP,才走 lo。
- 这正是 kube-proxy 把规则同时挂 PREROUTING + OUTPUT 的原因:两类不同来源的流量都要劫持,而不是同一包的两段流程(conntrack 已记录 NAT,不会对同一连接二次 DNAT)。
1. 容器 ↔ 容器(同 Pod 内)
Pod 内所有容器共享同一个 network namespace,共用一个 IP 和 MAC 地址。
Pod (10.244.1.5)
  ├─ 容器A :8080
  └─ 容器B :9090
容器间通过 localhost 直接通信,不经过 CNI、不经过路由:
| |
这是唯一不走 CNI 的通信路径。Pod 内容器共享 IP,端口不能冲突。
2. Pod ↔ Pod
2.1 同节点 Pod 通信
同节点 Pod 通信的本质:两个 Pod 的 veth pair 都接进同一台宿主机内核,由内核直接转发,流量不出物理网卡。
最经典的数据面结构是网桥模型(源自 ①篇 §3 的 Docker 单机网络):
PodA eth0 ──vethA── cni0 ──vethB── PodB eth0
- PodA 发帧:目的 MAC 填 PodB 的 MAC(先 ARP 学习)
- 帧经 vethA 进入宿主机,落在 cni0 网桥上
- cni0 查 CAM 表(MAC → 端口)→ 命中 vethB 端口
- 帧转发给 vethB → PodB eth0
网桥是最常见的数据面,但并非唯一——不同 CNI 的数据面结构并不完全相同,具体差异在后续的 Calico、Cilium 篇展开。这里先以网桥模型讲清同节点转发原理。
2.2 跨节点 Pod 通信
这是 CNI 插件的核心战场。无论具体插件,跨节点 Pod 通信不外乎两种机制(详见 ②篇):
Overlay(封装):在原始 IP 包外再封一层,走物理网络,对端解封后还原
PodA → veth → cni0 → VTEP(flannel.1 / tunl0)封装 → eth0 → 物理网络
  → 对端 eth0 → VTEP 解封装 → cni0 → veth → PodB
- 好处:对物理网络零要求,只要节点间 IP 可达
- 代价:封装/解封有开销,MTU 需额外留出封装头
Underlay(直接路由):把 Pod 子网路由直接刷进宿主机路由表,无封装
PodA → veth → cni0 → 匹配远端路由(下一跳 = 目标节点 IP)→ eth0 → 物理网络
  → 对端 eth0 → 匹配本机直连路由 → cni0 → veth → PodB
- 好处:零封装开销,性能等于裸机
- 代价:要求节点 L2 直连(下一跳 on-link),不能跨三层路由设备
关键技术点回顾(详见 ①篇):
- IPAM 给 Pod 分配唯一 IP
- 跨节点路由信息由 CNI 插件维护
- 数据包到达机制:封装(Overlay)或直接路由(Underlay)
3. Pod ↔ Service
Service 是 K8S 的抽象层,提供稳定的虚拟 IP 和端口。Pod IP 会变,Service IP 不变。
3.1 Service 的流量路径
先明确 K8s 网络里的分工:iptables 规则由 kube-proxy 承载(管 Service 的虚拟 IP → Pod IP),路由表由 CNI 组件维护在每台节点上(管 Pod IP 的可达性)。两者接力完成 Pod ↔ Service 通信——前者做 DNAT 改写,后者负责把改写后的包送到后端 Pod。
| |
Service 由每台节点上的 kube-proxy 实现。ClusterIP 是虚拟 IP——不绑定任何网卡:
| 对比 | 载体 |
|---|---|
| Pod IP | 绑定 Pod 的 eth0(veth 容器端),有 MAC、能 ARP |
| ClusterIP | 无接口、无 MAC,只存在于 API Server 字段 + 内核规则 |
所以 ClusterIP 不做 ARP。Pod 访问它时,按默认路由发到网关(cni0),包进入宿主机栈后,在路由决策之前被 PREROUTING 链 DNAT 改写成后端 Pod IP,之后才走正常的 Pod 路由。没有设备承载这个 IP,它靠内核规则劫持可达。
3.2 DNAT 与 SNAT:什么时候改写源 IP
过 Service 的流量永远做 DNAT(虚拟 IP → Pod IP,包才进得了 Pod 网络)。但不是都做 SNAT——只有回包无法原路返回时才需要:
| # | 场景 | 客户端 | 后端 | DNAT | SNAT | 回包路径 |
|---|---|---|---|---|---|---|
| 1 | Pod → ClusterIP | Pod | 同节点 | ✅ | ❌ | cni0 桥转发回源 Pod(conntrack un-DNAT) |
| 2 | Pod → ClusterIP | Pod | 跨节点 | ✅ | ❌ | 跨节点 Pod 路由回源 Pod |
| 3 | hairpin | Pod | 就是自己 | ✅ | ✅ | 源换成 cni0,避免「源=目的=自己」 |
| 4 | 宿主机进程 → ClusterIP | 宿主机 | 任意 | ✅ | ❌ | 回宿主机 IP,可达 |
| 5 | 外部 → NodePort/LB | 集群外 | 任意 | ✅ | ✅ | 源换成接收节点 IP,回包必须回原节点 |
一句话判据:要不要 SNAT,只看「回包能不能原路回到做 DNAT 的节点」。 能 → 不 SNAT(靠 conntrack 反 DNAT);不能 → SNAT 强制它回来。具体两种:① 客户端=后端自己(hairpin);② 客户端在集群外。
回包靠 conntrack 自动反向,不需要额外规则——DNAT 记录了「ClusterIP ↔ Pod IP」映射,回包时 conntrack 把源从后端 Pod IP 还原成 ClusterIP(un-DNAT)。
3.3 iptables 规则结构
以 iptables 模式为例,一个 ClusterIP Service(n 个 ready 后端)对应三类链:
| |
| 链 | 规则数 | 作用 |
|---|---|---|
| KUBE-SERVICES | 1 | 匹配 -d ClusterIP:port → 跳转 KUBE-SVC |
| KUBE-SVC-xxx | n | 负载均衡(statistic 概率) |
| KUBE-SEP-yyy(×n) | 2×n | ①条件打 MASQ 标记 ②DNAT |
| 入口合计 | 3n + 1 | 仅 DNAT 方向 |
三类链嵌入内核 netfilter 的完整链路:
PREROUTING ── KUBE-SERVICES ────────────────┐(①入口链)
              -d ClusterIP:port -j KUBE-SVC  │ 匹配则跳
                                             ▼
KUBE-SVC-xxx(②负载均衡链,n 条)            │
  -m statistic --probability 0.5 -j KUBE-SEP-a
  -j KUBE-SEP-b                              │(兜底)
                                             ▼
KUBE-SEP-yyy(③DNAT 链,每后端 2 条)        │
  -s <podIP>/32 -j KUBE-MARK-MASQ            │(条件标记)
  -j DNAT --to-destination <podIP:port>      │(真 DNAT)
                                             │
──── 路由决策(目的已改后端 Pod IP)─────────┘
FORWARD(转发到后端)
POSTROUTING ── KUBE-POSTROUTING
  -m mark --mark 0x4000 -j MASQUERADE(识别标记才 SNAT)
入口链的分类:PREROUTING vs OUTPUT
KUBE-SERVICES 同时挂在两条链,取决于「客户端是谁」——内核 netfilter 对「转发包」和「本地产生的包」走不同的钩子:
| 客户端 | 入口链 | 后续路径 | 本质 |
|---|---|---|---|
| Pod / 其他节点转发来的流量 | PREROUTING | FORWARD → POSTROUTING | 转发路径,包「路过」本机 |
| 宿主机自身进程 | OUTPUT | POSTROUTING | 本地路径,包「发自」本机 |
① Pod 客户端(转发路径):
  Pod → veth → cni0
  → PREROUTING:KUBE-SERVICES → KUBE-SVC → KUBE-SEP(标记 + DNAT)
  → 路由决策 → FORWARD → 后端
  → POSTROUTING:识别标记 MASQUERADE

② 宿主机进程(本地路径):
  进程 → OUTPUT:KUBE-SERVICES → KUBE-SVC → KUBE-SEP(标记 + DNAT)
  → 路由决策(DNAT 后重新路由)
  → POSTROUTING:识别标记 MASQUERADE
区别:转发包先过 PREROUTING 再过 FORWARD;本地产生的包不过 PREROUTING/FORWARD,从 OUTPUT 直接进入。kube-proxy 要把 KUBE-SERVICES 同时挂在这两个钩子上,才能同时劫持「Pod 访问」和「宿主机进程访问」两类流量(如 kubelet 访问某 Service)。
出口方向(回包)几乎不新增规则——靠 conntrack 状态表自动反向,只有全局共享的 MASQ 规则:
3.4 iptables 模式 vs IPVS 模式
| 维度 | iptables | IPVS |
|---|---|---|
| 转发机制 | Netfilter NAT 规则链 | Linux 内核 L4 负载均衡 |
| 负载均衡算法 | 随机(statistic 模块,probability) | 多种:rr、lc、dh、sh 等 |
| 性能 | 规则数 >1000 时性能下降明显 | 哈希表查找,O(1),大规模规则性能好 |
| 内核态切换 | 需要经过 Netfilter 钩子 | 在内核空间直接处理 |
| 默认模式 | K8S < 1.11 默认 | K8S ≥ 1.11 默认(需加载 ip_vs 内核模块) |
建议: 生产环境优先用 IPVS。大规模集群(>1000 Service)iptables 规则数量级增长会明显影响延迟。
3.5 流量路径示意
客户端 Pod                  kube-proxy                      后端 Pod
    │                          │                                │
    │ 1. 目标 IP = Svc:ClusterIP│                                │
    │                          │                                │
    │ 2. 内核匹配 iptables/ipvs│                                │
    │    规则:DNAT 到后端 Pod IP │                                │
    │                          │                                │
    │ 3. 目标 IP 改写为 Pod IP  │                                │
    │ ────────────────────────────────────────────────────────► │
    │                          │                                │
    │ 4. 走 CNI Pod ↔ Pod 路径 │                                │
    │                          │                                │
    │ 5. 回复包经 conntrack     │                                │
    │    un-DNAT 还原源为 ClusterIP│                             │
    │ ◄──────────────────────────────────────────────────────── │
4. 集群外 → Service(外部入站流量)
4.1 NodePort
在每个节点上开放指定端口(30000-32767),外部流量到达节点端口后转发给 Service:
| |
外部流量必须做 SNAT(MASQUERADE):TCP 是 4 元组,客户端只认它连的 node1:30001,而 DNAT 在 node1 做。不 SNAT,后端 Pod 会直接把回包发给外部客户端,源 IP 变成后端 egress,4 元组对不上被丢弃。SNAT 把源改成 node1 的 IP,强制回包回到 node1 做 un-DNAT,客户端才认。
注:跟后端 Pod 在不在 node1 无关——即使后端就在本节点也要 SNAT(见 §3.2 第 5 类)。
不推荐直接用于生产——端口管理不便、无法做 TLS 终结、缺少高级负载均衡能力。
4.2 LoadBalancer
云环境(AWS、GCP、Azure)或私有方案(MetalLB)为 Service 分配外部 IP:
| |
4.3 Ingress
L7 反向代理,通过域名和路径路由到不同 Service:
| |
Ingress 典型配置:
| |
4.4 ServiceType 总览
| ServiceType | 外部可达 | 典型场景 | 实现方式 |
|---|---|---|---|
| ClusterIP | 否 | 集群内互通 | 默认类型,仅分配内网 IP |
| NodePort | 是 | 开发测试 | 每节点开端口,直连节点 IP:Port |
| LoadBalancer | 是 | 生产环境 | 云 LB 或 MetalLB 分配公网 IP |
| ExternalName | 逻辑可达 | DNS CNAME | 返回 CNAME 记录,无代理 |
5. Pod → 集群外(Egress 出站流量)
Pod 访问外网时,源 IP 需要被替换为宿主机 IP(SNAT):
| |
关键规则(iptables 视角):
| |
- 源地址来自 Pod 子网,出接口不是
cni0,就执行 SNAT - 回包到达宿主机时,内核根据连接跟踪表(conntrack)做反向 DNAT,送回 Pod
适用场景: 大部分 K8S 集群默认配好 SNAT。如果 Pod 直接使用宿主机网络(
hostNetwork: true),则 Pod 的源 IP 就是宿主机 IP,不需要 SNAT。
6. 服务发现
Pod 需要知道要访问哪个 Service,K8S 提供两种机制:
6.1 DNS(推荐)
CoreDNS(或 kube-dns)作为集群内 DNS 服务,watch API Server 中的 Service 变化,自动创建 DNS 记录:
| |
DNS 记录命名格式:
| |
6.2 环境变量
Kubelet 在 Pod 启动前,为每个已存在的 Service 注入环境变量:
| |
限制: Service 必须在 Pod 之前创建才会注入。Pod 启动后新增的 Service,已有 Pod 不会获得环境变量。因此生产环境依赖 DNS。
7. Calico 的实现差异
前面各节用 Flannel 的网桥模型讲原理。Calico 是另一种主流数据面,核心区别在没有网桥:
数据面结构: Calico 的 veth 对端(cali*)直接进宿主机网络栈,每个 Pod 一条 /32 路由(10.244.1.5/32 dev caliXXX scope link),不经过网桥。
同节点 Pod 通信: 不再走网桥 CAM,而是内核按路由表在 veth 之间做 L3 转发——PodA → caliA → 路由表匹配 PodB 的 /32 → caliB → PodB。
跨节点 Pod 通信: 两种模式
- BGP(Underlay):把 /32 路由通过 BGP 广播给其他节点,无封装,性能高
- IPIP/VXLAN(Overlay):底层网络不支持 BGP 时退回封装
Service / NetworkPolicy: Service 默认仍走 kube-proxy(iptables/ipvs)。Calico 的核心价值是 NetworkPolicy——Felix 组件把策略翻译成 iptables/ipset 规则下发到每个节点。
一句话:Flannel 靠网桥(L2),Calico 靠路由(L3)。同节点 Calico 也走路由、没有 CAM 转发,这是两者数据面最本质的差异。封装与 BGP 细节见 ③篇。
